错题复习系统
让复习发生在遗忘之前
从 PDF 和图片入库,到题目提取、复习卡片与带截止日约束的 SM-2 调度。我围绕自己的学习需求,把一条完整的复习流程接起来。
- 我负责
- 需求定义、全栈实现组织、调试与验收
- 协作方式
- 个人项目 · AI 辅助开发
- 技术与工具
- Python / FastAPI / SQLite / JavaScript / 视觉模型 / SM-2
- 源码
- 私有仓库,仅公开摘要
验证与边界
有依据的进展
- PDF / 图片上传、文本与视觉双路径抽取、文件和题目去重
- 四档记忆反馈、SM-2 调度、考试截止日约束与超期排程压缩
- 7 个响应式视图;仓库包含算法、迁移、接口与前端交互测试
还没验证,或需要留意
- 视觉识别结果需要核对,复杂版式切题仍有启发式限制
- 抽取使用单进程后台线程,尚未引入持久化任务队列
- 没有独立用户鉴权;部署文档要求反向代理登录门禁,本次未复验线上服务
开发记录问题、取舍与过程
从一份错题文件开始
我想解决的不是“再做一个题库”,而是让已经整理出来的错题,能在合适的时候重新出现。文件入库、识别、纠错和复习安排要连在一起,否则整理本身就会成为负担。
系统先判断材料的类型:有可靠文本层的 PDF 用规则切题;扫描件和照片交给视觉模型;对于结构清楚的错题本导出,还会直接提取单道题的图片。无法可靠分离的区域会提示核对,而不是把答案图片当成题干。
一个算法,也要服从真实的截止日
常规间隔复习追求长期记忆,但一次有截止日期的考试提出了不同要求:如果题目的下次间隔比剩余天数还长,它就再也不会在考前出现。
我把截止日作为独立约束叠加到调度器上,给所有天级间隔加上限,包括新卡毕业和“轻松”选项。已经排到截止日以后的题目,可以重新平均铺到剩余时间里。算法保留确定性,方便用测试核对每一次状态变化。
把“复盘”留给使用者
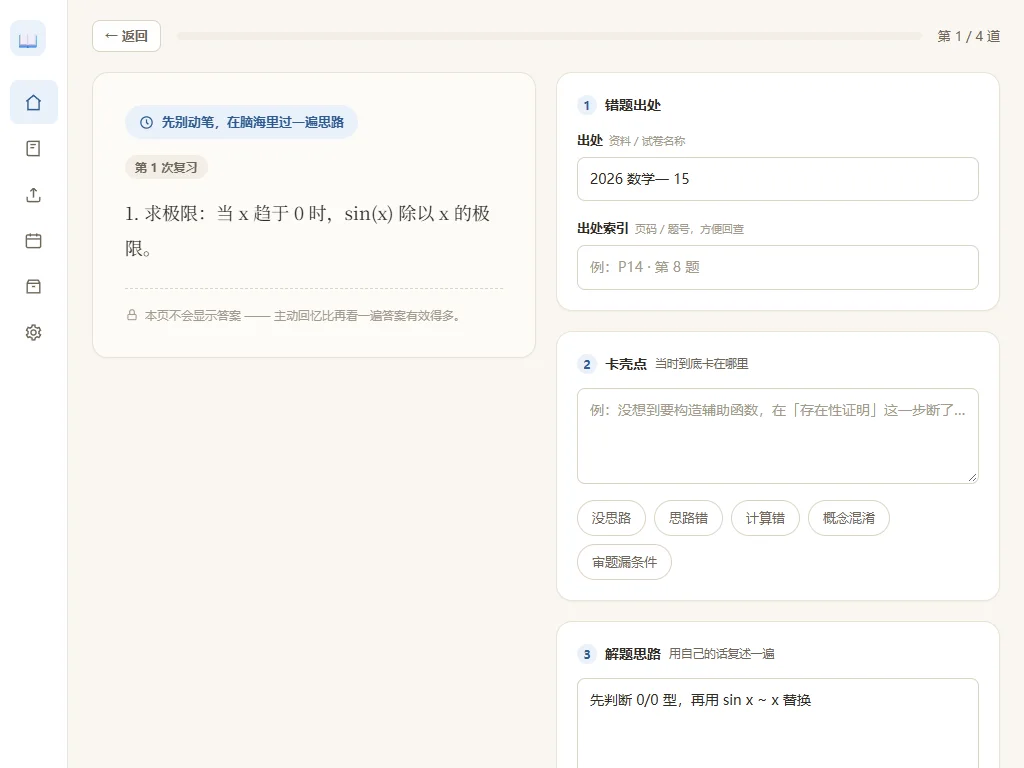
页面会记录自评、出处、知识点和卡壳点。模型可以提取印刷信息,但解题思路需要我自己填写。四档反馈会先预览实际间隔;选中反馈后,再明确保存并继续。
我在其中的工作
我定义学习流程与边界,借助 AI 编程工具组织实现,持续检查算法、数据迁移、题干预览和部署路径。我的贡献包括需求取舍、集成、问题排查与验收,不意味着每行代码都是我手写的。
目前的结果
仓库保留了可运行代码、界面截图、测试入口和服务器部署脚本。它已经形成完整的个人使用流程;模型识别的准确度、批量抽取的可靠性和公网访问保护,仍然需要分别看待。这里的项目状态来自仓库证据,没有把旧部署记录当作本次线上可用性测试。
模拟一张卡片的复习。选择记忆反馈,观察下一次排期;不连接题库,不保存数据。
点击任意反馈,开始一次模拟复习。
这份记录从哪里来
资料核对于 2026-11-12。以下是整理时阅读的文件与记录,不代表本次重新执行了源项目的硬件、部署或完整回归。
- 项目说明与部署边界
README.md - 确定性调度器
app/scheduler.py - 调度与截止日回归
tests/test_scheduler.py - 子路径回归
tests/test_url_prefix.py
源仓库为私有,仅保留适合公开的摘要。内部地址、凭证、财务原文及个人计划未公开。